IA évolutive
Des systèmes d’IA qui continuent de fonctionner de manière fiable à mesure que les jeux de données, les modèles, le nombre d’utilisateurs et les charges de travail augmentent.
L’IA évolutive désigne la capacité des systèmes d’IA, des modèles, des pipelines de données, des infrastructures et des opérations à maintenir leurs performances, leur fiabilité et leur rentabilité à mesure que la demande et la complexité augmentent. C’est ce qui distingue un projet pilote d’IA fonctionnant en laboratoire d’une solution d’IA capable de prendre en charge à grande échelle les charges de travail réelles d’une entreprise.
Qu’est-ce que l’IA évolutive ?
L’IA évolutive permet de créer des systèmes capables de s’étendre pour gérer davantage de données et d’utilisateurs, des modèles plus volumineux et des sites distribués, sans perte de performances ni coûts élevés. Une véritable évolutivité exige une croissance synchronisée de l’ensemble de la pile d’IA, notamment des pipelines de données, des modèles, des clusters de GPU, des réseaux, de l’inférence et des opérations.
Un modèle qui fonctionne en phase de développement se retrouve souvent bloqué lors du passage à l’échelle en production : les pipelines de données ne sont pas prêts, les points de terminaison d’inférence peinent à gérer les accès simultanés, ou le réseau devient le goulot d’étranglement à la place de la puissance de calcul.
L’évolutivité se manifeste dans plusieurs dimensions fondamentales :
- Mise à l’échelle des données : Passage de jeux de données ponctuels à des pipelines en temps réel à haut débit
- Mise à l’échelle des modèles : Passage d’un modèle unique à de nombreux modèles et variantes déployés dans différentes régions
- Mise à l’échelle de l’infrastructure : Veiller à ce que les ressources GPU/CPU, le stockage et le réseau suivent le rythme de la croissance
- Mise à l’échelle opérationnelle : Amélioration des processus de mise en production, de l’observabilité, de l’ingénierie du trafic et de la gestion des coûts
Lorsqu’elle est mise en œuvre efficacement, une IA évolutive offre des performances fiables et constantes à mesure que les charges de travail augmentent. Cette transformation permet de faire passer l’IA du stade des expérimentations pilotes à celui de capacités robustes déployées à l’échelle de l’entreprise. En établissant des bases solides pour la gestion du trafic, la sécurité et la visibilité — des domaines sur lesquels F5 se concentre tout particulièrement — les entreprises peuvent faire évoluer leur IA rapidement et en toute confiance, sans risquer de déstabiliser leurs systèmes ni d’accumuler une dette opérationnelle cachée.
Pourquoi l’IA évolutive est-elle importante ?
Sans capacité de mise à l’échelle, les initiatives d’IA atteignent rapidement leurs limites. Les organisations peuvent créer des preuves de concept (POC), mais passer à l’échelle pour traiter des milliers, voire des millions de requêtes quotidiennes constitue un tout autre défi.
Il est essentiel de se pencher sur l’IA évolutive, car :
- La demande métier dépasse les capacités des architectures initiales, et l’intégration de l’IA accélère la croissance du trafic de manière imprévisible. La plupart des déploiements d’IA commencent avec un seul modèle, un seul flux de travail et une seule équipe. Une fois leur valeur démontrée, leur adoption s’étend à d’autres unités, provoquant des pics de trafic à mesure que de nouvelles applications se connectent à des points de terminaison partagés. Des systèmes initialement conçus pour traiter des milliers de requêtes par heure en gèrent désormais des millions par jour. Sans infrastructure réseau évolutive, cette croissance rapide peut saturer l’infrastructure.
- À grande échelle, les systèmes d’IA peuvent connaître des défaillances insidieuses, entraînant des pics de latence, une sous-utilisation des GPU, une surcharge des modèles ou des blocages dans les pipelines de données qui nuisent à la fiabilité. Les défaillances de l’IA provoquent rarement des pannes majeures ; elles se traduisent généralement par une dégradation des performances. Les GPU restent souvent inactifs, les requêtes d’inférence s’accumulent dans les files d’attente en cas de forte charge, ou la latence augmente aux heures de pointe. Un mauvais routage du trafic ou une partition de données trop lente peut perturber l’ensemble du pipeline. Ces problèmes systémiques se manifestent généralement en conditions de charge réelles, ce qui les rend difficiles à diagnostiquer sans une observabilité adéquate et une gestion intelligente du trafic.
- Les coûts d’exploitation augmentent rapidement en raison de chemins d’inférence inefficaces, d’une concurrence non maîtrisée et d’un trafic mal régulé, ce qui peut doubler ou tripler les dépenses liées au cloud. Les coûts d’inférence augmentent en raison d’une mauvaise gestion du trafic, de requêtes non regroupées en lots, d’une charge inégalement répartie, de chemins d’accès aux GPU nécessitant un démarrage à froid ou d’un routage inadapté, entraînant une mise à l’échelle inutile et un surdimensionnement des ressources. Les GPU dans le cloud sont coûteux ; sans une gestion adéquate, les équipes finissent par payer pour des GPU inutilisés ou des réplicas excédentaires. De nombreuses entreprises constatent que les problèmes de réseau, et non la complexité des modèles, sont à l’origine des coûts et dépenses liés à l’inférence.
- La conformité et la gouvernance nécessitent des outils adaptés aux entreprises. L’IA en production exige des garde-fous dont les projets pilotes sont souvent dépourvus. Les premiers projets pilotes d’IA manquent fréquemment de contrôles formels, tels que la sécurité des API, le suivi de la traçabilité des modèles et la gouvernance des données. Mais lorsque l’IA traite des données clients, intervient dans des processus réglementés ou manipule des contenus sensibles, les organisations doivent mettre en place des mesures de protection telles que l’application des politiques, les pistes d’audit, les contrôles d’accès, le chiffrement et la gestion des versions. Ces mesures sont indispensables au déploiement de l’IA dans la finance, la santé, les administrations publiques ou les entreprises internationales.
- L’avantage concurrentiel s’accroît avec le passage à l’échelle. Une inférence plus rapide, des itérations plus nombreuses sur les modèles et une meilleure expérience utilisateur permettent de se différencier durablement. L’évolutivité protège le système et stimule l’innovation. Les équipes capables de réentraîner rapidement les modèles, de déployer des mises à jour ou de fournir une inférence à faible latence bénéficient d’un avantage concurrentiel. Les utilisateurs profitent d’une meilleure réactivité, les fonctionnalités sont mises à disposition plus rapidement et les modèles sont affinés plus souvent. Cette rapidité opérationnelle crée une barrière concurrentielle difficile à surmonter.
Une IA évolutive permet à une entreprise de développer ses cas d’usage en toute confiance, qu’il s’agisse de prendre en charge un nombre croissant d’utilisateurs, de mettre en œuvre des modèles plus complexes ou de déployer l’IA dans différentes régions et sur diverses plateformes cloud.
Comment fonctionne l’IA évolutive ?
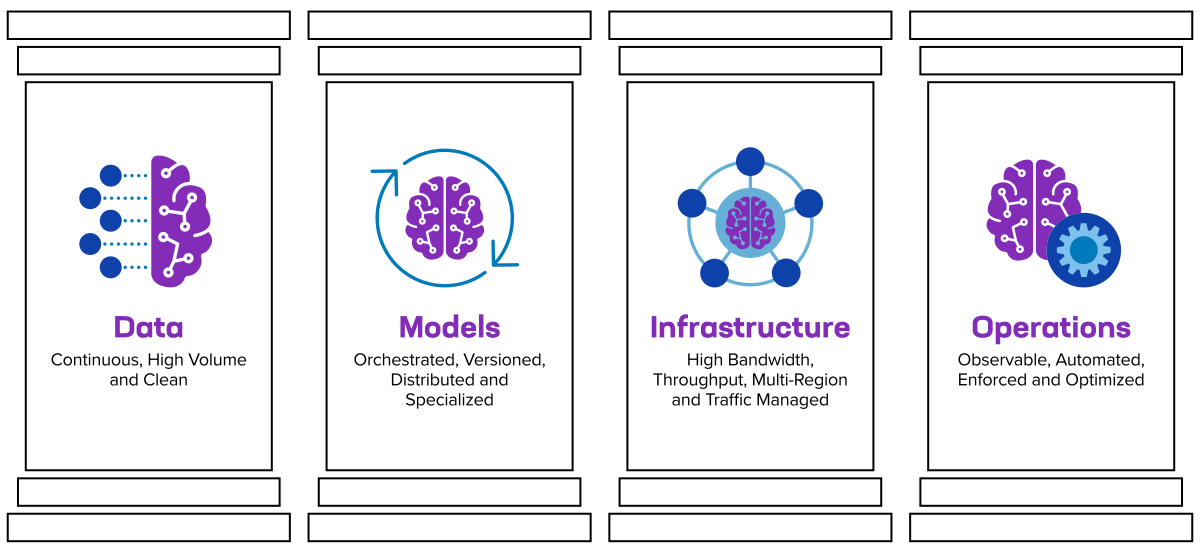
L’IA évolutive repose sur la coordination de quatre piliers de croissance : les données, les modèles, l’infrastructure et les opérations. Ces quatre piliers doivent être alignés. Si un seul d’entre eux prend du retard, l’ensemble du système s’en trouve limité.
1. Mise à l’échelle des données
Les données constituent souvent le premier goulot d’étranglement. Les systèmes d’IA ont besoin de pipelines de données continus, fiables et à haut débit pour prendre en charge l’entraînement et l’inférence sans surcharger les GPU ni perturber les flux de travail, même lorsque le volume de données augmente.
- Ingestion continue des données : Les pipelines d’IA doivent extraire de manière fiable et sécurisée des données en temps réel provenant de plusieurs sources afin de garantir que les modèles utilisent des données d’entrée récentes et précises.
- Pipelines de données à haut débit : Les systèmes doivent acheminer rapidement les données afin d’exploiter pleinement les GPU et d’éviter les périodes d’inactivité dues à des flux d’entrée lents ou irréguliers.
- Référentiels de caractéristiques et bases de données vectorielles : Ces systèmes standardisent, stockent et mettent à disposition des caractéristiques ou des plongements à grande échelle, tout en garantissant la reproductibilité et une inférence à faible latence.
- Contrôles de la qualité et de la cohérence des données : Des données propres, validées et dont la traçabilité est assurée réduisent la dérive des modèles, préviennent les défaillances des pipelines et renforcent la confiance dans les résultats produits par les modèles.
- Systèmes de stockage évolutifs : Le stockage sous-jacent doit évoluer avec le jeu de données afin de permettre un accès parallèle, une récupération rapide et des performances prévisibles à mesure que le volume augmente.
2. Modèles de mise à l’échelle
Les entreprises passent rapidement d’un modèle unique à des centaines de modèles, notamment des versions distillées, des variantes propres à certaines tâches et des modèles affinés. La capacité à faire évoluer les modèles ne se limite pas à augmenter leur nombre de paramètres ; elle comprend également :
- Orchestration multimodèle : La coordination de plusieurs modèles garantit que le bon modèle s’exécute au bon moment, sans surcharger le point de terminaison.
- Gestion des versions, déploiements progressifs et restaurations : La gestion des versions des modèles, avec des déploiements progressifs contrôlés et des restaurations instantanées, évite les interruptions de service et permet une amélioration continue en toute sécurité.
- Inférence distribuée : L’exécution de l’inférence sur plusieurs nœuds ou régions réduit la latence et équilibre la charge, évitant ainsi les goulets d’étranglement au niveau d’un GPU ou d’un cluster unique.
- Spécialisation des modèles par région ou cas d’usage : Le déploiement de variantes adaptées à différents marchés ou tâches améliore les performances et l’efficacité en faisant correspondre chaque modèle au contexte qui lui convient le mieux.
3. Mise à l’échelle de l’infrastructure
Les charges de travail d’IA nécessitent des ressources de calcul, de stockage et de mise en réseau hautes performances. À mesure que leur utilisation augmente, les organisations doivent accroître leur capacité en GPU et :
- Réseau à haut débit : Le réseau doit offrir des connexions à faible latence et à haut débit afin que les GPU soient continuellement alimentés en données, au lieu d’être ralentis par des liaisons saturées.
- Stockage à haut débit : Les systèmes de stockage doivent fournir un accès continu et parallèle à d’immenses jeux de données afin d’éviter les goulets d’étranglement liés aux entrées-sorties lors de l’entraînement et de l’inférence.
- Déploiement multirégional : La répartition de l’infrastructure entre plusieurs régions améliore la résilience et réduit la latence en rapprochant les ressources de calcul et les modèles des utilisateurs et des sources de données
- Orientation du trafic et équilibrage de charge à la vitesse de la ligne : Le routage intelligent et ultrarapide du trafic assure une répartition homogène des requêtes d’inférence, afin d’exploiter pleinement les clusters de GPU et d’éviter les points de congestion.
L’infrastructure doit rester efficace, car la capacité des GPU est coûteuse et un routage inefficace du trafic entraîne du gaspillage.
4. Mise à l’échelle des opérations
Même le matériel le plus robuste ne peut compenser des opérations défaillantes. L’IA d’entreprise exige :
- Observabilité de la latence, du débit et du coût par inférence : Les équipes ont besoin d’une visibilité en temps réel sur le comportement des modèles et de l’infrastructure afin de détecter les goulets d’étranglement, d’optimiser les performances et d’éviter les défaillances silencieuses.
- Réponse aux incidents liés à la dégradation des modèles : Lorsque la précision diminue ou que la latence augmente brusquement, les organisations doivent rapidement diagnostiquer les causes profondes et rétablir un service stable sans perturber les utilisateurs.
- Pipelines de déploiement automatisés : Une automatisation fiable garantit le transfert sécurisé des mises à jour des modèles de l’environnement de développement à celui de production, sans les risques liés aux interventions manuelles.
- Application des politiques et gouvernance : Des contrôles rigoureux sont nécessaires pour protéger les points de terminaison des modèles, faire respecter les règles d’accès et garantir la conformité dans les environnements d’IA complexes
- Visibilité et optimisation des coûts : Le suivi de l’utilisation des GPU, de l’inférence et de l’efficacité du routage aide les équipes à maîtriser les coûts et à éviter les opérations de mise à l’échelle inutiles.
Comment F5 répond-il aux enjeux fondamentaux de l’IA évolutive ?
F5 aborde l’IA évolutive sous l’angle des principaux défis auxquels les entreprises sont confrontées en matière d’ingénierie du trafic, de sécurité et de visibilité. Ces couches deviennent souvent le goulet d’étranglement à mesure que les charges de travail d’IA augmentent, même dans les organisations disposant de nombreux GPU et d’architectures de modèles avancées.
F5 aide les entreprises à déployer l’IA à grande échelle en :
- Optimisation de l’utilisation des GPU grâce au routage intelligent du trafic : Le débit d’inférence de l’IA varie en fonction de la répartition des requêtes. F5 BIG-IP Local Traffic Manager (LTM) assure l’équilibrage de charge, le routage tenant compte des modèles et l’optimisation des chemins de trafic pour réduire la latence, afin que les clusters de GPU restent pleinement sollicités et efficaces au lieu d’être ralentis par des flux de requêtes lents ou irréguliers.
- Élimination des goulets d’étranglement du réseau : L’inférence à forte concurrence peut saturer les piles réseau traditionnelles bien avant que les ressources de calcul n’atteignent leur capacité maximale. La plateforme F5 BIG-IP et F5 Distributed Cloud App Connect gèrent les situations de bande passante extrême et réduisent la congestion, garantissant ainsi un acheminement fluide du trafic d’inférence vers tous les points de terminaison.
- Sécurisation des points de terminaison d’inférence et des API de modèles : Les services d’IA reposent sur des API qui nécessitent une véritable protection applicative de couche 7, et non un simple filtrage des paquets. F5 BIG-IP Advanced WAF, F5 Distributed Cloud Web App and API Protection (WAAP) et F5 BIG-IP SSL Orchestrator assurent une inspection approfondie (y compris du trafic chiffré), l’application des politiques, la prévention des bots et des abus, ainsi que des protections à l’exécution afin de protéger les modèles sensibles et les routes d’inférence.
- Assurer la visibilité dans les environnements d’IA hybrides : Le trafic lié à l’IA transite par différents environnements, souvent selon des schémas peu clairs et incohérents. F5 Distributed Cloud App Stack, associé à la fonction de diffusion en continu des données de télémétrie de BIG-IP, fournit aux équipes des données en temps réel sur la latence, le débit, les performances des points de terminaison des modèles, la profondeur des files d’attente et l’état des API, ce qui permet aux opérateurs d’optimiser les performances et de résoudre les problèmes avant qu’ils n’affectent les utilisateurs.
- Prise en charge de pipelines de données modernes, compatibles S3 et à haut débit : Pour les pipelines d’ingestion et d’entraînement de l’IA à forte intensité de données, BIG-IP accélère les flux à haut volume vers le stockage objet compatible S3. Avec des partenaires tels que NetApp StorageGRID, F5 garantit une mise à l’échelle fluide des pipelines de données en fonction des charges de travail d’entraînement des modèles et de récupération des données.
Les couches de gestion du trafic, de sécurité et de visibilité de F5, fournies via BIG-IP et Distributed Cloud Services, sont conçues pour garantir que les charges de travail d’IA restent fiables, efficaces et performantes face à une demande croissante.
Pourquoi l’évolutivité est importante dès les premières étapes du développement
Aujourd’hui, les systèmes d’IA évoluent plus rapidement que les infrastructures qui les prennent en charge. Les modèles gagnent en ampleur, les cas d’usage s’élargissent et le nombre d’utilisations simultanées augmente à mesure que les organisations intègrent l’IA à leurs produits, à leurs processus et à leurs expériences client. Parallèlement, les exigences en matière de coûts se durcissent et les impératifs de gouvernance rehaussent les normes de rigueur opérationnelle.
L’évolutivité ne se résume pas à l’optimisation : c’est une condition fondamentale pour garantir la fiabilité et la reproductibilité de l’IA à l’échelle d’une organisation. Sans une base solide et évolutive, chaque nouvelle application d’IA risque de devenir un projet sur mesure, avec des performances inégales et des coûts croissants.
Les entreprises qui investissent tôt dans une infrastructure d’IA évolutive servant de socle opérationnel à leur IA bénéficient des avantages suivants :
- Cycles d’itération plus rapides
- Réduction des coûts d’exploitation
- Des performances plus constantes
- Fiabilité et sécurité accrues
- Une approche durable pour une adoption à l’échelle de l’entreprise
Architecture et infrastructure pour une IA évolutive
La capacité de l’IA à évoluer repose sur une infrastructure capable de s’adapter aux exigences des charges de travail. Les entreprises envisagent généralement quatre options d’architecture : le cloud, l’infrastructure sur site, l’architecture hybride et l’edge computing.
- Évolutivité de l’IA dans le cloud : Le cloud accélère l’expérimentation et l’augmentation des capacités, mais se heurte à des problèmes de coûts et de latence lors du passage à grande échelle. Les contraintes comprennent la gestion du trafic, la disponibilité des GPU et la prévisibilité des performances.
- Évolutivité de l’IA sur site : Les solutions sur site offrent des coûts prévisibles, une gouvernance stricte des données et des performances stables, mais nécessitent une planification rigoureuse de l’alimentation électrique, du refroidissement et du réseau, en particulier pour les clusters denses de GPU.
- Architectures d’IA hybrides : La plupart des entreprises adoptent ce type d’architecture, l’entraînement étant souvent effectué dans le cloud, l’inférence en périphérie et l’ajustement fin sur un cluster de GPU dédié. L’évolutivité repose sur la fiabilité du réseau, du routage et de la sécurité entre les différents environnements.
- IA en périphérie — évolutivité : L’inférence en périphérie réduit les coûts et la latence, mais nécessite la distillation des modèles, des stratégies de réplication et une gestion efficace du trafic entre les appareils en périphérie et le cloud.
Technologies clés permettant de déployer l’IA à grande échelle :
- Conteneurs et orchestration
- Bases de données vectorielles et magasins de caractéristiques
- Frameworks d’entraînement distribué
- CI/CD pour le ML (pipelines MLOps)
- Registres de modèles et gestion des versions
- Gestion du trafic et routage de couche 7
- Pipelines de stockage d’objets compatibles avec S3
La mise en réseau joue un rôle central dans le déploiement de l’IA à grande échelle, car les clusters denses de GPU génèrent un trafic est-ouest important, tandis que les tâches d’inférence exigent résilience, faible latence et routage intelligent. Les capacités de F5 sont essentielles dans ce contexte.
Bonnes pratiques pour la mise à l’échelle des modèles d’IA
La mise à l’échelle des modèles d’IA repose avant tout sur la conception des services, et pas uniquement sur l’optimisation des modèles. Pour garantir une inférence fiable et rentable, les organisations doivent harmoniser leur architecture et leurs processus opérationnels.
- Concevez des services sans état et évolutifs horizontalement : Séparez l’environnement d’exécution du modèle de l’état et veillez à ce que les points de terminaison puissent s’adapter automatiquement au trafic.
- Utilisez le traitement par lots, la mise en cache et le fractionnement des données en blocs faciles à gérer (partitionnement) : Ces techniques réduisent la sollicitation des GPU et atténuent les pics de requêtes simultanées. De nombreuses organisations réalisent d’importantes économies en appliquant systématiquement ces pratiques.
- Gérez les versions des modèles avec rigueur: les déploiements, les tests A/B et les retours à une version antérieure doivent être rapides et sécurisés. Une mauvaise gestion des versions reste l’une des principales causes d’incidents d’inférence.
- Surveillez les métriques de premier plan : La latence, le débit, le coût par inférence, l’utilisation du GPU, le taux d’expiration des requêtes et la profondeur de la file d’attente doivent tous être surveillés en temps réel.
- Remédiez rapidement au manque de maturité des données : Les problèmes de qualité des données, tels que les pipelines cloisonnés, les étiquettes incorrectes et l’absence de traçabilité, deviennent des obstacles persistants à mesure que l’échelle augmente. Investir dans la préparation des données apporte souvent davantage de bénéfices que de simplement développer l’infrastructure de données et les GPU.
- Intégrez un routage tenant compte des modèles : Les schémas de trafic liés à l’IA ne sont pas uniformes. Un routage fondé sur le type et la taille du modèle, la longueur de la file d’attente ou la région de l’utilisateur améliore considérablement les performances et l’efficacité.
Défis liés à la mise en œuvre d’une IA évolutive
Le déploiement de l’IA à grande échelle pose des défis sur les plans technologique, organisationnel et financier.
- Les goulets d’étranglement techniques comprennent notamment une infrastructure fragmentée, des réseaux sous-dimensionnés ou mal configurés, des systèmes de stockage incapables de prendre en charge les GPU et des points de terminaison d’inférence sensibles à la latence qui rencontrent des problèmes en cas de forte charge.
- Les lacunes organisationnelles comprennent le cloisonnement des équipes d’IA et d’infrastructure, une maturité insuffisante en matière de MLOps, ainsi qu’un manque de prise en charge et de responsabilité concernant l’IA en production.
- Les contraintes de coût et de capacité comprennent la pénurie de GPU, l’imprévisibilité du trafic d’inférence, les pics de coûts liés au cloud et un routage inefficace qui réduit le taux d’utilisation des GPU.
- La sécurité et la gouvernance sont essentielles. Les ressources sensibles des modèles doivent être isolées, le trafic chiffré (qui masque les menaces) doit être inspecté, l’accès aux API doit être géré de manière cohérente et une visibilité en temps réel est indispensable pour détecter la dérive des modèles et les utilisations abusives.
C’est là que F5 se démarque en éliminant les goulets d’étranglement du réseau, en sécurisant le trafic et les API, et en offrant la visibilité nécessaire pour permettre aux équipes de déployer l’IA à grande échelle en toute confiance, plutôt que de recourir à des solutions de fortune.
IA évolutive | FAQ
Qu’est-ce que l’IA évolutive, concrètement ?
Une IA qui maintient des performances fiables à mesure que la demande, le volume de données et la complexité des modèles augmentent.
En quoi la scalabilité diffère-t-elle du simple ajout de GPU ?
Atteindre une véritable évolutivité repose sur une croissance coordonnée des pipelines de données, des réseaux, des opérations et des architectures de modèles, et non sur de simples améliorations matérielles isolées.
Quels facteurs influencent la capacité de l’IA à passer à l’échelle ?
La préparation des données, l’architecture des modèles, la capacité réseau, l’utilisation des GPU, la gestion des accès simultanés et la gouvernance sont autant d’éléments clés sur lesquels se concentrer.
Comment les organisations doivent-elles aborder le choix entre le cloud et une infrastructure sur site ?
Le cloud accélère l’expérimentation, tandis que les solutions sur site améliorent la prévisibilité et la gouvernance. Par conséquent, la plupart des entreprises adoptent généralement une approche hybride.
Pourquoi les projets pilotes d’IA s’enlisent-ils avant leur passage à l’échelle en production ?
Les causes courantes incluent le manque de maturité des données, une connectivité réseau limitée, la sous-utilisation des GPU, un routage inefficace, des processus opérationnels défaillants et une répartition floue des responsabilités.
Quel est l’impact du réseau sur l’inférence à grande échelle ?
La latence, le débit et l’utilisation des GPU sont influencés par le routage, la gestion des accès simultanés et l’ingénierie du trafic.
Par où les équipes devraient-elles commencer ?
Concentrez-vous sur la visibilité. Identifiez les contraintes actuelles, telles que le réseau, les données et la saturation des GPU, puis élaborez une feuille de route en fonction de ces goulots d’étranglement.
Comment F5 peut vous aider
Une IA évolutive constitue le fondement d’une IA d’entreprise efficace. Elle nécessite des pipelines de données intégrés, des architectures de modèles robustes, une infrastructure haute performance, une connectivité réseau fiable, une gouvernance solide et des opérations rigoureuses. Les organisations qui investissent dès maintenant peuvent étendre leurs applications d’IA en toute confiance et de manière rentable, sans compromettre les performances ni la sécurité.
Découvrez comment F5 Application Delivery and Security Platform aide les organisations à déployer leurs initiatives d’IA à grande échelle sur f5.com/solutions/ai-delivery-and-security.